Aus Dokumenten werden nutzbare Informationen
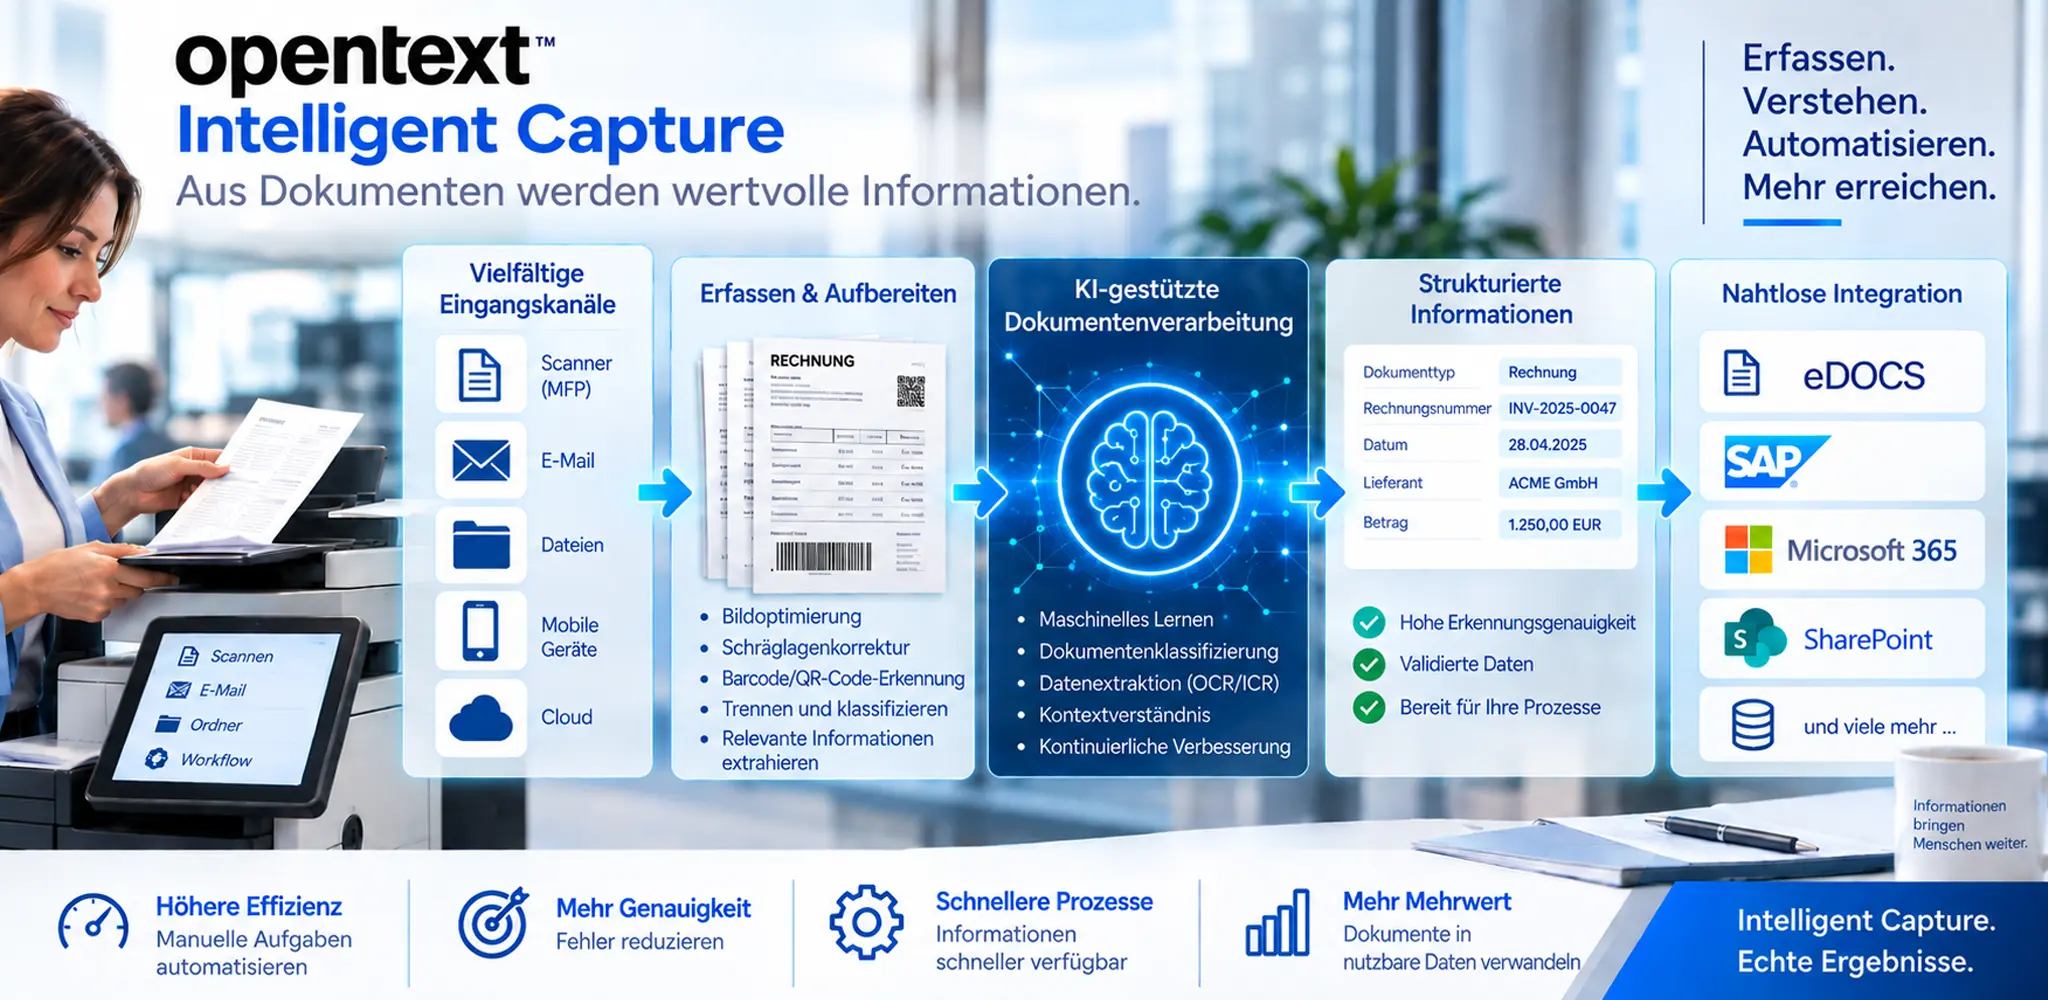
Eine der zentralen Aufgaben bei der Digitalisierung von Dokumenten besteht darin, deren Inhalt nicht nur digital abzubilden, sondern auch automatisch zu verstehen und relevante Informationen für nachgelagerte Geschäftsprozesse verfügbar zu machen. Dazu müssen Dokumente erkannt, klassifiziert und die benötigten Informationen zuverlässig extrahiert werden.
Die Anforderungen unterscheiden sich dabei je nach Dokumententyp:
Strukturierte Dokumente
Formulare zum Beispiel besitzen einen weitgehend fest definierten Aufbau und feste Positionen für bestimmte Informationen.
Semistrukturierte Dokumente
Rechnungen, Lieferscheine oder Bestellung enthalten vergleichbare Informationen, deren Position und Darstellung jedoch von Dokument zu Dokument variieren können.
Unstrukturierte Dokumente
Anschreiben, Verträge oder sonstige Korrespondenz, bei denen relevante Informationen erst aus dem inhaltlichen Zusammenhang erkannt werden können.
Langjährige Erfahrung in der intelligenten Dokumentenerkennung
Seit vielen Jahren beschäftigen wir uns mit der automatisierten Erkennung, Klassifizierung und Datenextraktion von Dokumenten. Dabei haben wir unterschiedliche Generationen von Capture- und Recognition-Technologien begleitet – von früheren Lösungen und Technologien wie DoKuStar und OpenText Capture Center (OCC) bis hin zu den heutigen intelligenten Capture-Plattformen.
Mit OpenText Capture, vormals OpenText Intelligent Capture, stehen heute moderne Verfahren zur Verfügung, die klassische OCR-Technologien mit Machine Learning und Künstlicher Intelligenz kombinieren.Damit können Dokumente automatisch klassifiziert und relevante Informationen gezielt extrahiert werden.
Erkennen – Klassifizieren – Extrahieren – Validieren
Ein typischer Intelligent-Capture-Prozess umfasst mehrere Schritte:
1. Erkennen
Eingehende Papier- oder elektronische Dokumente werden analysiert und für die weitere Verarbeitung aufbereitet.
2. Klassifizieren
Das System erkennt automatisch, um welche Art von Dokument es sich handelt – z.B. Rechnung, Lieferschein, Vertrag oder Formular.
3. Extrahieren
Die jeweils benötigten Informationen werden aus dem Dokument ausgelesen – etwa die Rechnungsnummer, Bestellnummer oder Datum bei einer Rechnung.
4. Validieren
Erkannte Informationen können durch Regeln, vorhandene Stammdaten oder, wenn erforderlich, durch einen Anwender geprüft und korrigiert werden.
5. Übergabe
Im Anschluss werden Dokument und Daten automatisiert an das nachgelagerte ERP-, Dokumentenmanagement-, Archiv- oder Workflow-System übergeben.
Künstliche Intelligenz erweitert die Möglichkeiten
Moderne KI-Technologien verändern die klassische Dokumentenerkennung grundlegend. Während traditionelle Capture-Lösungen häufig auf fest definierten Regeln, Positionen und trainierten Dokumentklassen basierten, ermöglichen Machine Learning und neue KI-Verfahren zunehmend auch die Verarbeitung komplexer und variabler Dokumente.
Damit wird Intelligent Capture zu einem wichtigen Bindeglied zwischen eingehenden Dokumenten und automatisierten Geschäftsprozessen.Unser Ziel ist dabei nicht, möglichst viel KI einzusetzen, sondern für jeden Anwendungsfall die geeignete Kombination aus bewährter Dokumentenerkennung, Regeln, Machine Learning und modernen KI-Verfahren auszuwählen.
Erfahrung entscheidet über den Automatisierungsgrad
Eine leistungsfähige Capture-Technologie allein macht noch keinen erfolgreichen Prozess. Entscheidend ist, wie Dokumentenklassifizierung, Datenextraktion, Validierung und die Integration in nachgelagerte Systeme aufeinander abgestimmt werden.
Durch unsere langjährige Erfahrung mit Dokumentenerkennung und dokumentenbasierten Geschäftsprozessen unterstützen wir unsere Kunden dabei, aus eingehenden Dokumenten strukturierte und verlässliche Informationen für die automatisierte Weiterverarbeitung zu gewinnen.So wird aus einem gescannten oder elektronisch eingegangenen Dokument ein nutzbarer Bestandteil eines digitalen Geschäftsprozesses.
Weitere Informationen
OpenText Intelligent Classification
Nutzen Sie die Funktionen zur Verarbeitung natürlicher Sprache, um unstrukturierte Inhalte zu analysieren und die enthaltenen Informationen zu verarbeiten.
OpenText Continuous machine learning: Your AI edge
How OpenText leverages a continuous machine learning (CML) approach that offers flexibility, accuracy, and efficiency while minimizing or eliminating manual model retraining.